
Deux objets résumaient la partie data center de l’exposition, et ni l’un ni l’autre ne se commande comme un serveur de plus. D’un côté un nœud de calcul — l’Atlas 850E — que la fiche exposée décrit comme un « 14U compute node » et donne pour agrégeable en SuperPoDSuperPoD — 超节点 (super-nœud)Terme Huawei pour un ensemble de nœuds de calcul reliés par un bus à très haut débit et exploités comme une seule ressource de calcul. ; de l’autre la maquette d’un data center livré en modules, froid et onduleur compris. Deux échelles, un même mouvement : l’infrastructure se vend préintégrée. Ce dossier est donc assumé en niveau B/C — à comprendre, à budgéter, puis à monter en projet avec les équipes Huawei le jour où le besoin est là ; sa dernière partie, elle, redescend dans votre propre local technique.
Dossier 7 sur 9 · Data center & IA
Ne pas se tromper d’échelle
D’un côté des SuperPoD pour l’IA, de l’autre une salle serveurs livrée comme un produit fini. Entre les deux, la même question de dimensionnement.
Deux échelles, un même mouvement
En quelques allées, l’exposition passait du nœud de calcul géant à la salle serveurs préassemblée.
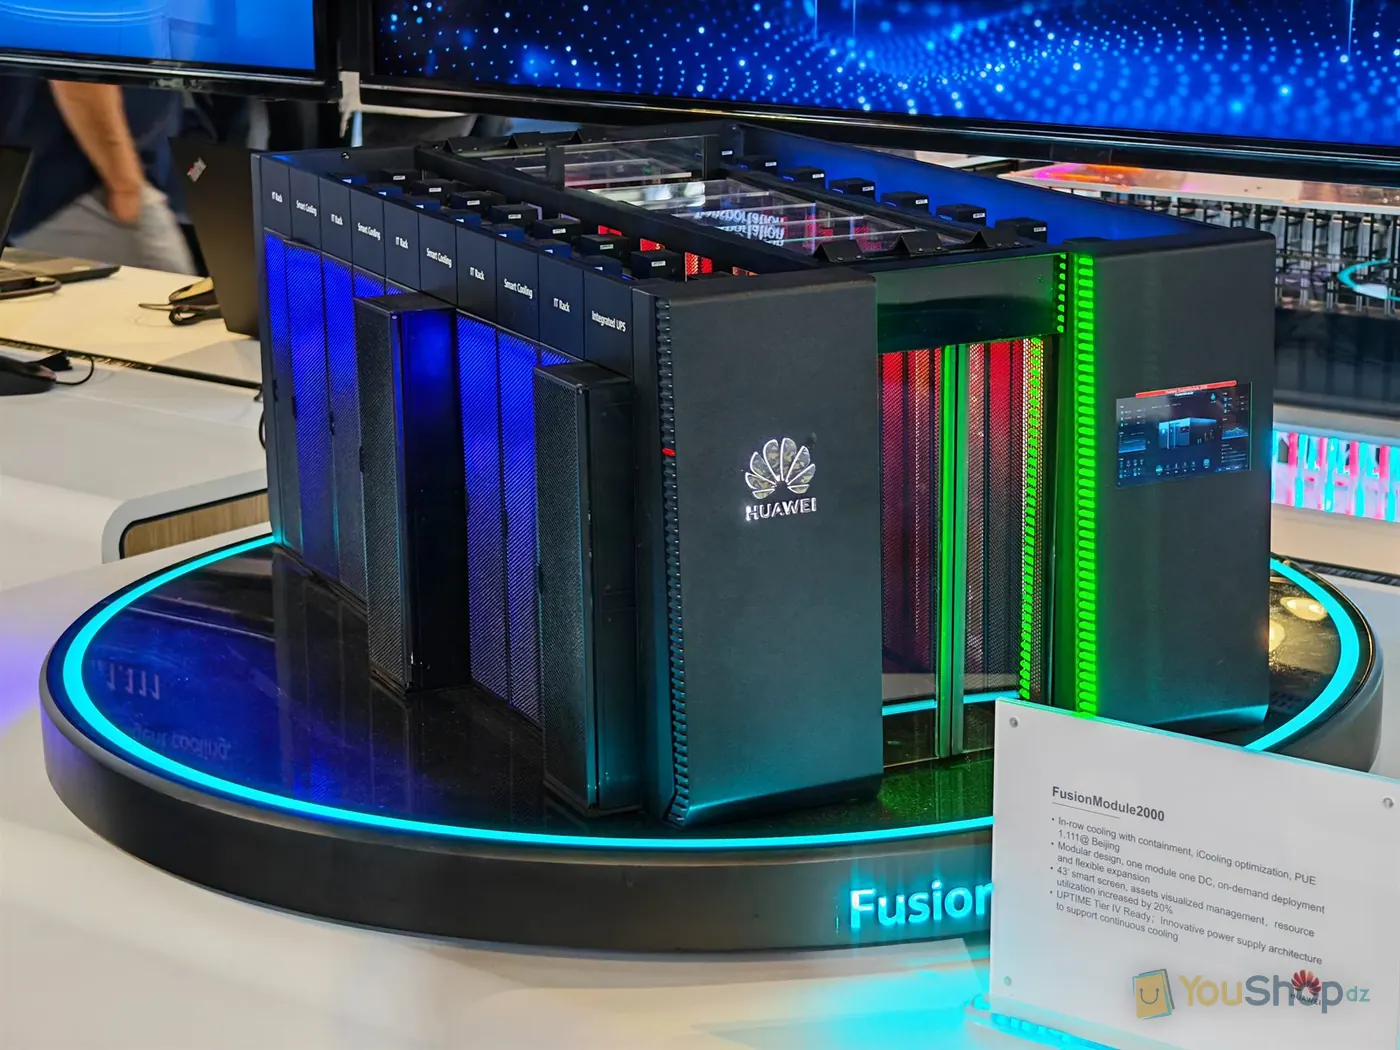
Un data center miniature sur un socle circulaire, et tout est dit : ce qui est vendu n’est plus une baie à glisser dans un local existant, c’est une salle entière — informatique, froid, énergie, supervision — assemblée puis déployée module par module. Le PUEPUE — Power Usage EffectivenessRapport entre l’énergie consommée par toute la salle et celle consommée par les serveurs seuls : 1,0 serait le cas parfait. affiché, 1,111 « @ Beijing » — donc relevé à Pékin —, reste une affirmation Huawei : nous la reprenons plus loin ligne par ligne.
Le nœud de calcul exposé plus tôt dans le parcours raconte la même histoire à l’autre bout de l’échelle : calcul, alimentation et refroidissement empaquetés dans un même châssis, prévu — la fiche est explicite — pour des armoires refroidies par air ordinaires. Le vocabulaire change, l’argument est identique. C’est par cette boîte-là que nous commençons, tiroir par tiroir.
Pour une entreprise algérienne, l’écart se mesure d’abord en préalables. Avant de parler de module préfabriqué, la question reste celle du local technique : confinement des allées, onduleur dimensionné, protection électrique en amont. À budgéter, donc, sur 12–24 mois et à traiter en projet avec Huawei, dont nous sommes Partenaire Élite : ces lignes ne figurent pas à notre catalogue en ligne, elles se montent au cas par cas — et c’est nous qui portons le dossier côté algérien.
SuperPoD : ce qu’il y a dans la boîte
Pour une fois, le constructeur avait ouvert la machine : une vitrine en coupe, un châssis ouvert sur une table et une plaque acrylique bilingue. De quoi regarder le mot « SuperPoD » de près, au lieu de le subir.
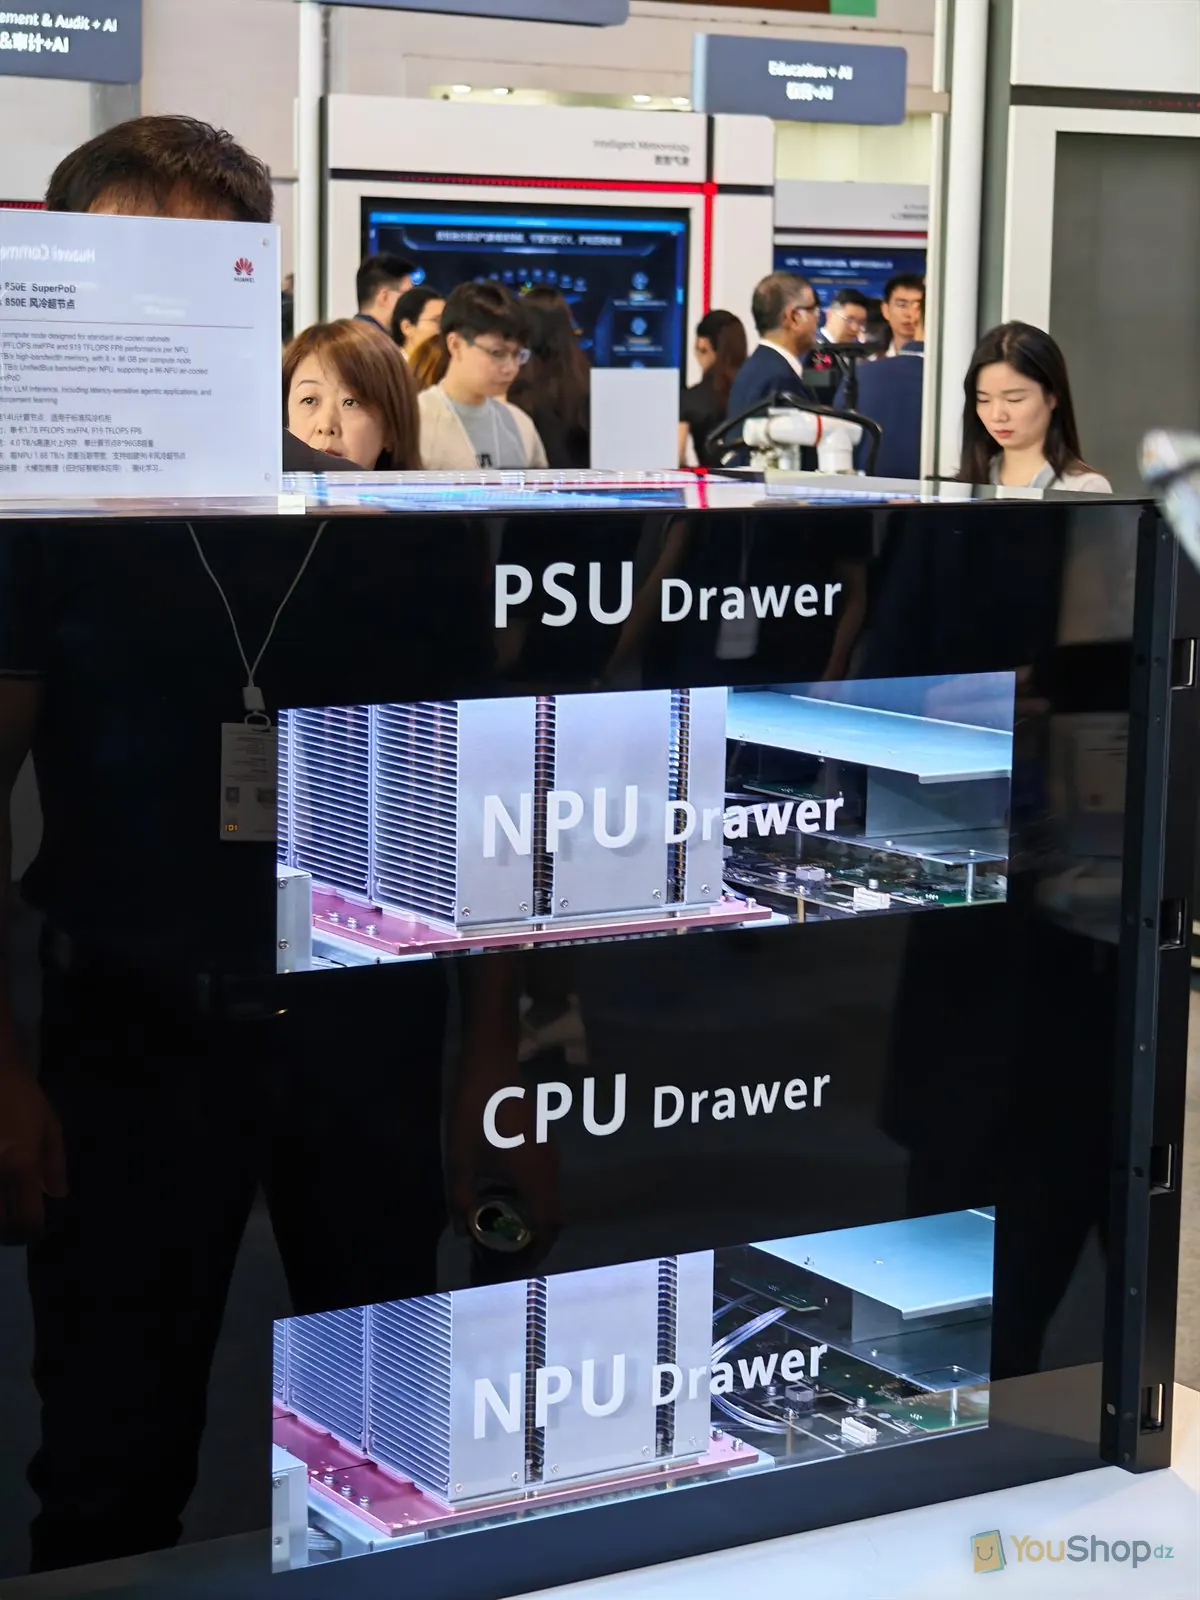
La vitrine se lit de haut en bas comme une armoire : PSU Drawer, NPU Drawer, CPU Drawer, NPU Drawer. Quatre niveaux étiquetés, le tiroir PSUPower Supply Unit (bloc d’alimentation)Le tiroir qui abrite l’alimentation électrique et ses ventilateurs, ici placé tout en haut du nœud. en tête. Seuls les deux tiroirs NPUNeural Processing UnitProcesseur spécialisé dans les calculs de réseaux de neurones, distinct du processeur central et de la carte graphique. sont donnés à voir derrière la vitre : des dissipateurs à ailettes massifs montés sur des cartes rouges. Rien de spectaculaire — et c’est tout l’intérêt : un supernœud n’est pas une puce, c’est une mécanique d’assemblage, d’alimentation et d’évacuation de chaleur.
Le châssis, ports compris
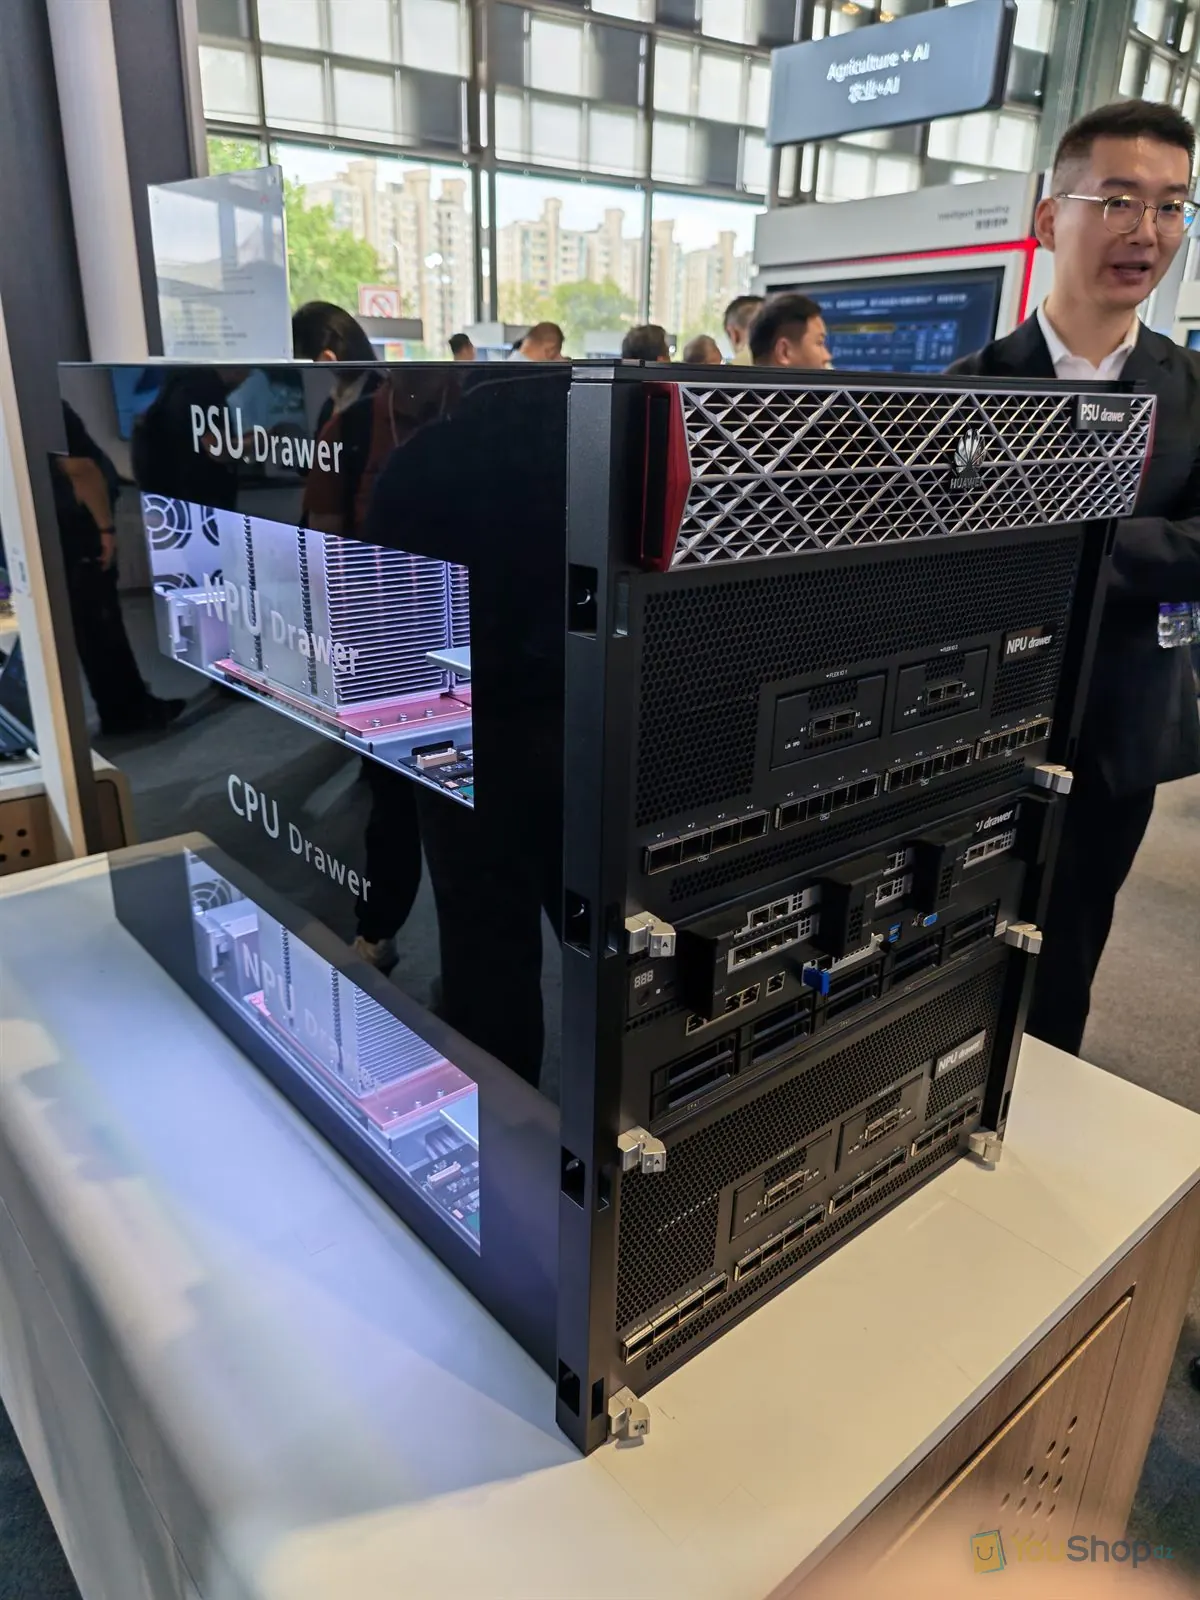
Sur la même table, le châssis lui-même était dressé à côté de la maquette éclatée, marquage A850. Les étiquettes de la vitrine se retrouvent en façade, cette fois sur la tôle : PSU drawer, NPU drawer (×2), CPU drawer. Sur les tiroirs NPU, deux emplacements FLEX IO 1 et FLEX IO 2, puis des rangées de cages optiques — seize ports par tiroir NPU. Un nœud de cette génération se juge donc autant au nombre de fibres qui en sortent qu’à sa puissance : une question de câblage avant d’être une question de silicium.
Ce que dit la fiche
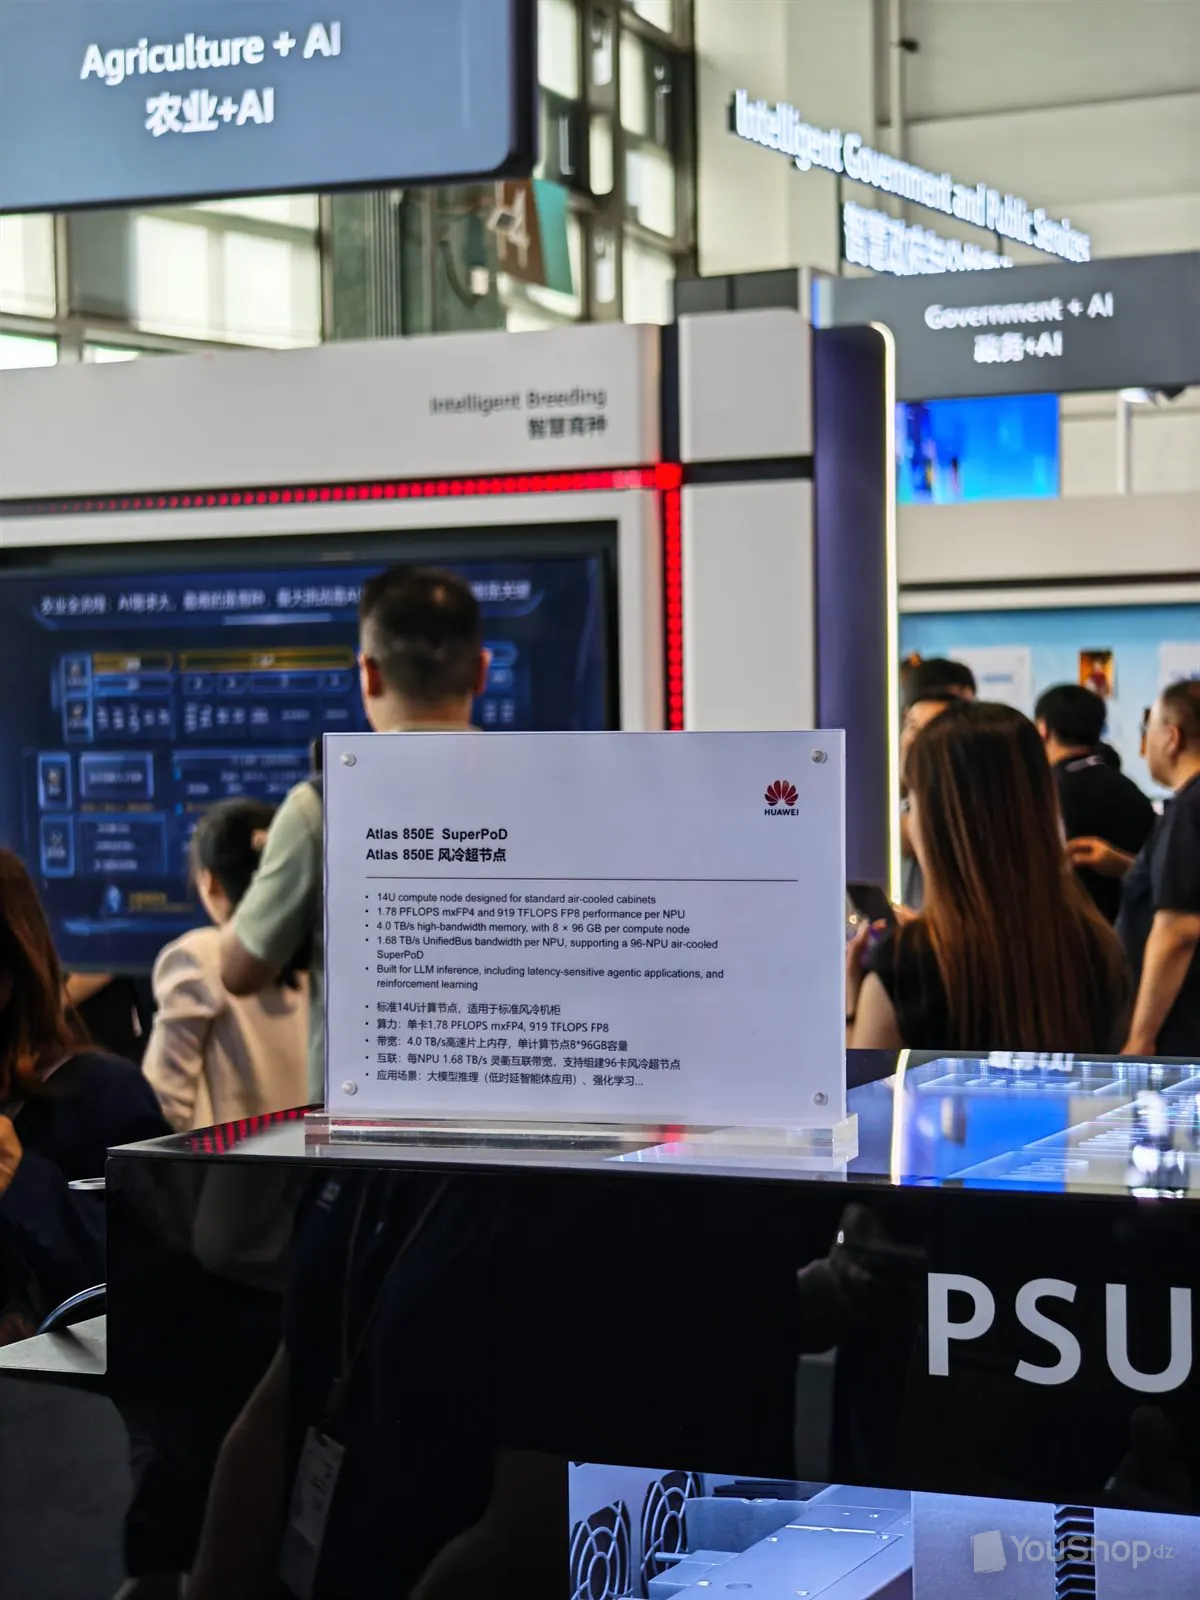
Ce que dit la fiche exposée — Atlas 850E SuperPoD
- 14U compute node designed for standard air-cooled cabinets
- 1.78 PFLOPS mxFP4 and 919 TFLOPS FP8 performance per NPU
- 4.0 TB/s high-bandwidth memory, with 8 × 96 GB per compute node
- 1.68 TB/s UnifiedBus bandwidth per NPU, supporting a 96-NPU air-cooled SuperPoD
- Built for LLM inference, including latency-sensitive agentic applications, and reinforcement learning
Fiche photographiée sur le stand, 17/09/2026.
Ligne à ligne : un nœud de calcul de 14 UU (unité de rack)Hauteur normalisée de 44,45 mm. Un serveur courant occupe 1 ou 2 U ; 14 U, c’est près du tiers d’une armoire complète pour un seul nœud. prévu pour des armoires refroidies par air ordinaires, donc sans circuit d’eau. Par NPU : 1,78 PFLOPSPFLOPS et TFLOPSPéta- et téra-opérations en virgule flottante par seconde, soit mille milliards (T) et un million de milliards (P) d’opérations par seconde. L’unité habituelle pour annoncer la puissance de calcul d’un accélérateur. en mxFP4 et 919 TFLOPS en FP8, deux formats de calcul à précision réduite. Par nœud : 8 × 96 Go de mémoire annoncés à 4,0 To/s. Et 1,68 To/s de bande passante UnifiedBusUnifiedBus (灵衢)Interconnexion Huawei entre cartes de calcul ; 灵衢 est le nom chinois de ce bus. La fiche Atlas 850E annonce 1,68 To/s par NPU et la constitution d’un supernœud de 96 NPU refroidi par air. par NPU, de quoi constituer, toujours selon la fiche, un supernœud refroidi par air de 96 NPU. Usage visé, écrit noir sur blanc : inférence de grands modèles, applications agentiques sensibles à la latence, apprentissage par renforcement. Faire tourner des modèles et les affiner, donc, plutôt que les entraîner depuis zéro.
Une précision d’honnêteté sur notre propre lecture. Sur la photo de la vitrine, la plaque est coupée au bord gauche et se lit « …4U计算节点 » (…4U, nœud de calcul). C’est la fiche complète, photographiée juste après sur le même stand, qui tranche : « 14U compute node / 标准14U计算节点 » (nœud de calcul 14U standard). Nous retenons 14 U. Le préfixe de gamme « Atlas » manquait lui aussi au premier cadrage et vient de cette même fiche.
Lire la suiteRéduire
Pourquoi empiler plutôt qu’aligner
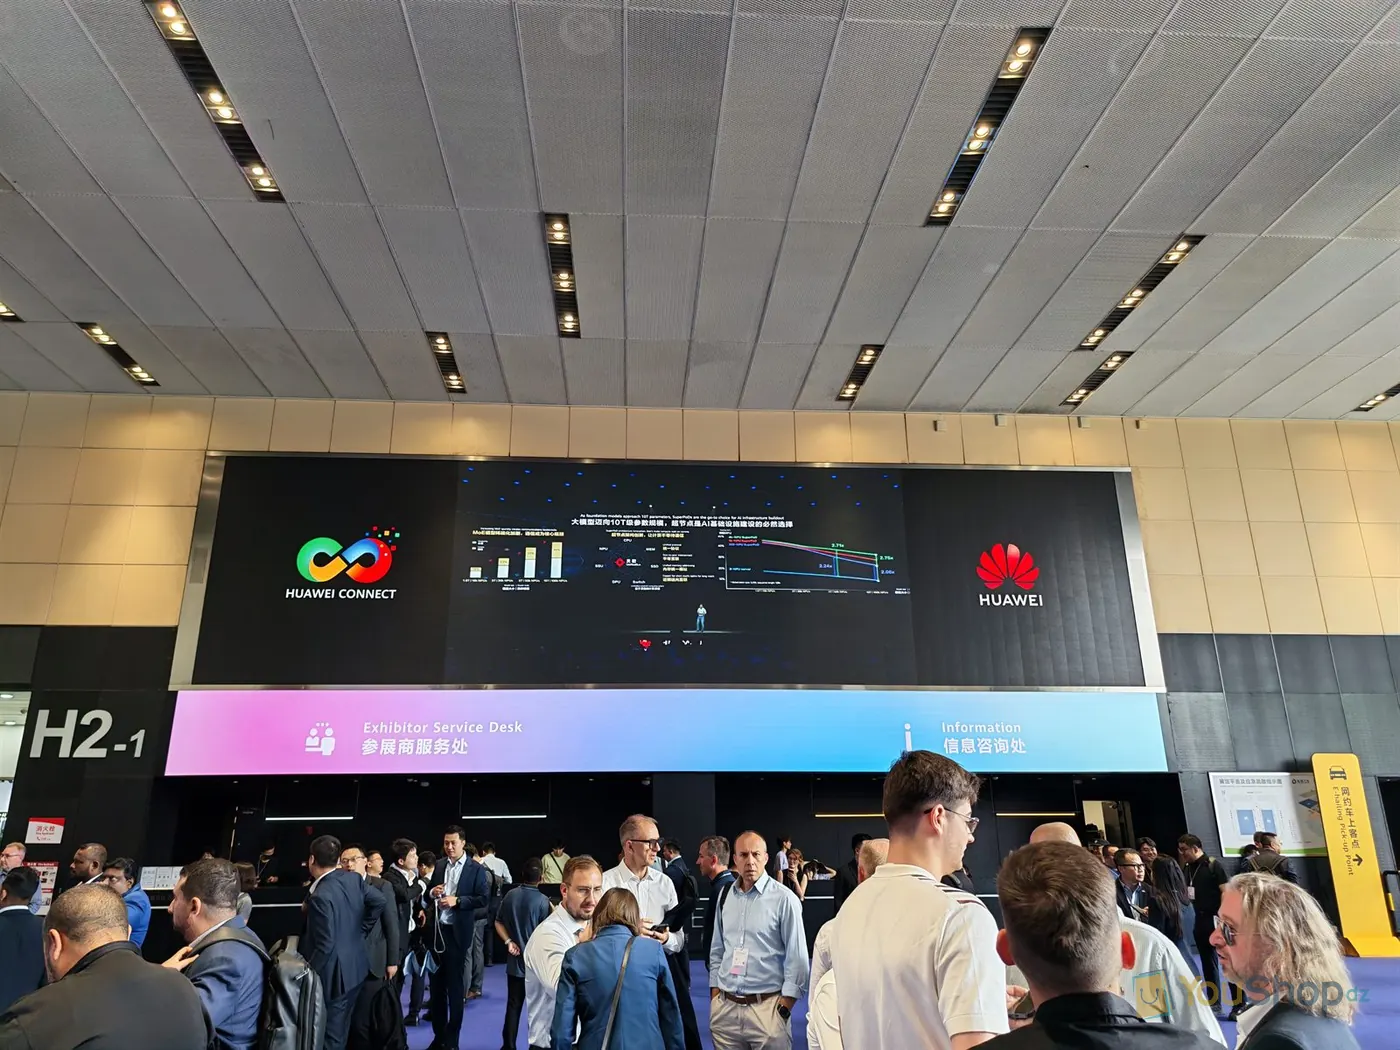
La justification tenait sur le mur LED du hall H2-1, au-dessus des comptoirs d’accueil : « As foundation models approach 10T parameters, SuperPoDs are the go-to choice for AI infrastructure buildout » — 大模型迈向10T级参数规模,超节点是AI基础设施建设的必然选择 (les grands modèles vont vers 10 000 milliards de paramètres ; le supernœud devient le choix obligé pour bâtir l’infrastructure d’IA). À gauche, un graphique sur l’évolution des architectures MoEMixture of Experts (mélange d’experts)Architecture de modèle où seule une fraction des paramètres est activée à chaque requête. Elle réduit le calcul par réponse, mais impose de garder l’ensemble du modèle accessible en mémoire — d’où la pression sur l’interconnexion. ; au centre, un schéma reliant CPU, NPU, MEM, SSD, GPU et Switch ; à droite, des courbes comparatives annotées 2,24×, 2,71×, 2,75× et 2,06×. Huawei n’y compare pas des puces : il compare des assemblages — et c’est, là encore, sa propre démonstration.
Et pour une entreprise algérienne ?
Les gammes Atlas et Ascend ne figurent pas à notre catalogue en ligne : elles se traitent en projet, au cas par cas, avec les équipes Huawei — et nous en sommes l’interlocuteur côté algérien, en tant que Partenaire Élite Huawei. Soyons clairs sur l’échelle : un supernœud d’entraînement se déploie par salles entières, chez un opérateur de cloud, un centre de recherche ou une institution qui bâtit son infrastructure d’IA. Si c’est votre sujet, décrivez-nous le besoin et nous ouvrons le dossier (0558 13 01 81 ou contact@youshop-dz.com). Pour toutes les autres tailles d’entreprise, ce qui se transpose, c’est la grille de lecture. Sur n’importe quel serveur, la question utile n’est plus « combien de cœurs ? » mais « combien de mémoire, à quelle bande passante, et qu’est-ce qui relie les cartes ? ». Les 14 U refroidis par air disent la suite : la densité se paie en climatisation et en puissance électrique.
FusionModule2000 et IT POD : le data center comme produit
Ce qui est présenté ici n’est pas une baie à installer, mais un module complet, froid et onduleur compris, avec son délai de déploiement affiché à l’écran.
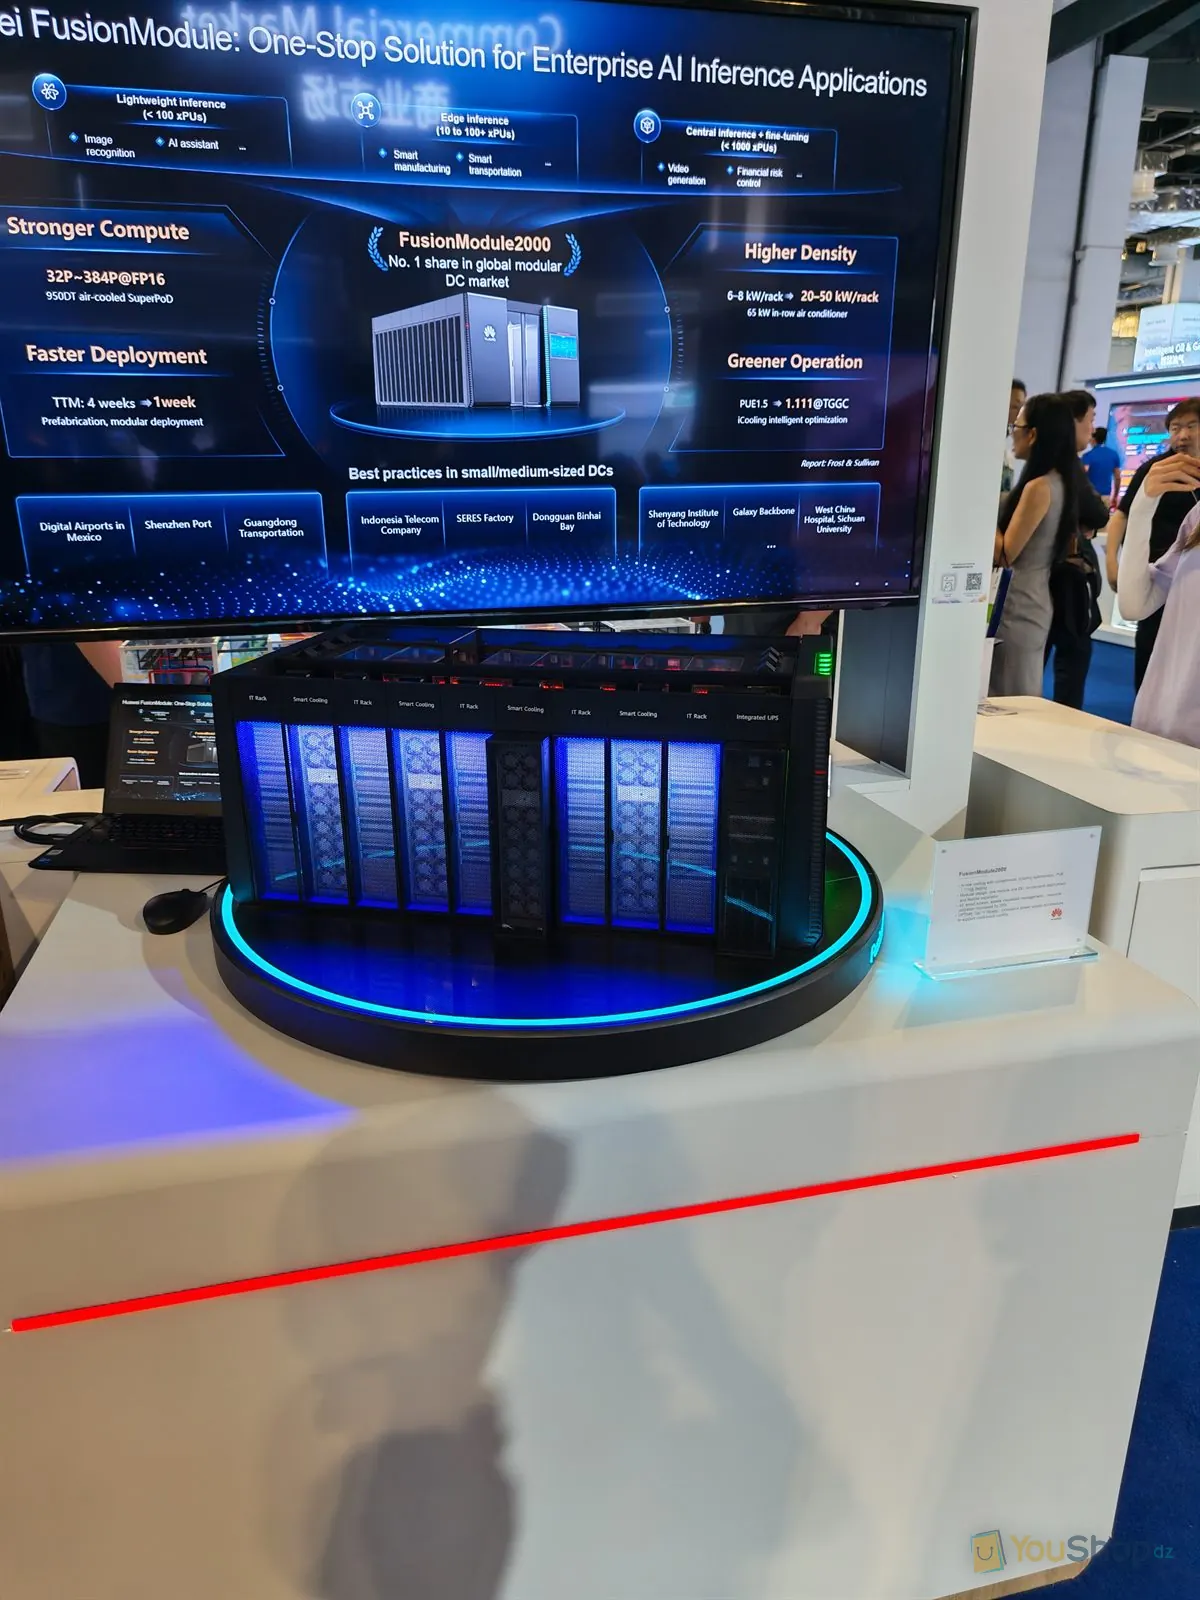
Plus loin dans l’exposition, après le nœud de calcul, l’échelle bascule : une maquette de module posée sur un socle circulaire cerclé d’un anneau LED, un grand écran derrière, une fiche produit en plexiglas sur le côté et un ordinateur portable qui rejoue la même diapositive. Le titre annonce la couleur : « Huawei FusionModule: One-Stop Solution for Enterprise AI Inference Applications ». Trois paliers de charge y sont distingués : « Lightweight inference (< 100 xPUs) », « Edge inference (10 to 100+ xPUs) », « Central inference + fine-tuning (< 1000 xPUs) ». Le dimensionnement s’exprime donc en xPUxPU — unité de calcul accéléréeTerme générique qui recouvre les accélérateurs de tous types, processeurs graphiques comme processeurs neuronaux., pas en serveurs ni en mètres carrés.
1 semaine
« TTM: 4 weeks → 1 week » : le time to market, délai entre la commande et la mise en service. Écran du stand.
20–50 kW/baie
« 6–8 kW/rack → 20–50 kW/rack », avec un « 65 kW in-row air conditioner ».
1,111
PUE annoncé : « 1.111@TGGC » à l’écran, « 1.111@ Beijing » sur la fiche.
N° 1
« No. 1 share in global modular DC market », rapport Frost & Sullivan cité par Huawei.
Chiffres relevés sur le stand le 17/09/2026 et reproduits tels quels : ce sont des affirmations de Huawei.
Ce que dit la fiche, ligne par ligne
Ce que dit la fiche exposée — FusionModule2000
- In-row cooling with containment, iCooling optimization, PUE 1.111@ Beijing
- Modular design, one module one DC, on-demand deployment and flexible expansion
- 43′ smart screen, assets visualized management, resource utilization increased by 20%
- UPTIME Tier IV Ready; Innovative power supply architecture to support continuous cooling
Fiche photographiée sur le stand, 17/09/2026.
Traduisons. « In-row cooling with containment » : la climatisation est intercalée entre les baies et l’allée est fermée, pour empêcher l’air chaud de repasser devant les serveurs. « One module one DC » : on n’achète plus un local que l’on équipe ensuite, mais des tranches de salle, ajoutées quand la charge monte.
Deux précisions. « UPTIME Tier IV Ready » se lit « conçu pour », pas « certifié » : la fiche annonce une conception, elle ne présente pas le certificat d’une installation donnée. Et le PUE n’est pas affiché deux fois de la même façon : « 1.111@ Beijing » sur la fiche, « 1.111@TGGC » à l’écran — un sigle que le stand n’explicite nulle part.
La densité appelle la même prudence : Huawei place lui-même le point de départ à « 6–8 kW/rack », et une salle de serveurs de gestion reste du côté de ce point de départ, loin des 50 kW par baie. Le module préfabriqué répond à une autre question — le délai et la cohérence d’ensemble.
Lire la suiteRéduire
IT POD : huit baies, vingt-huit jours
Sur le même stand, une seconde maquette en treillis blanc montrait à nu les circuits de refroidissement primaire et secondaire.
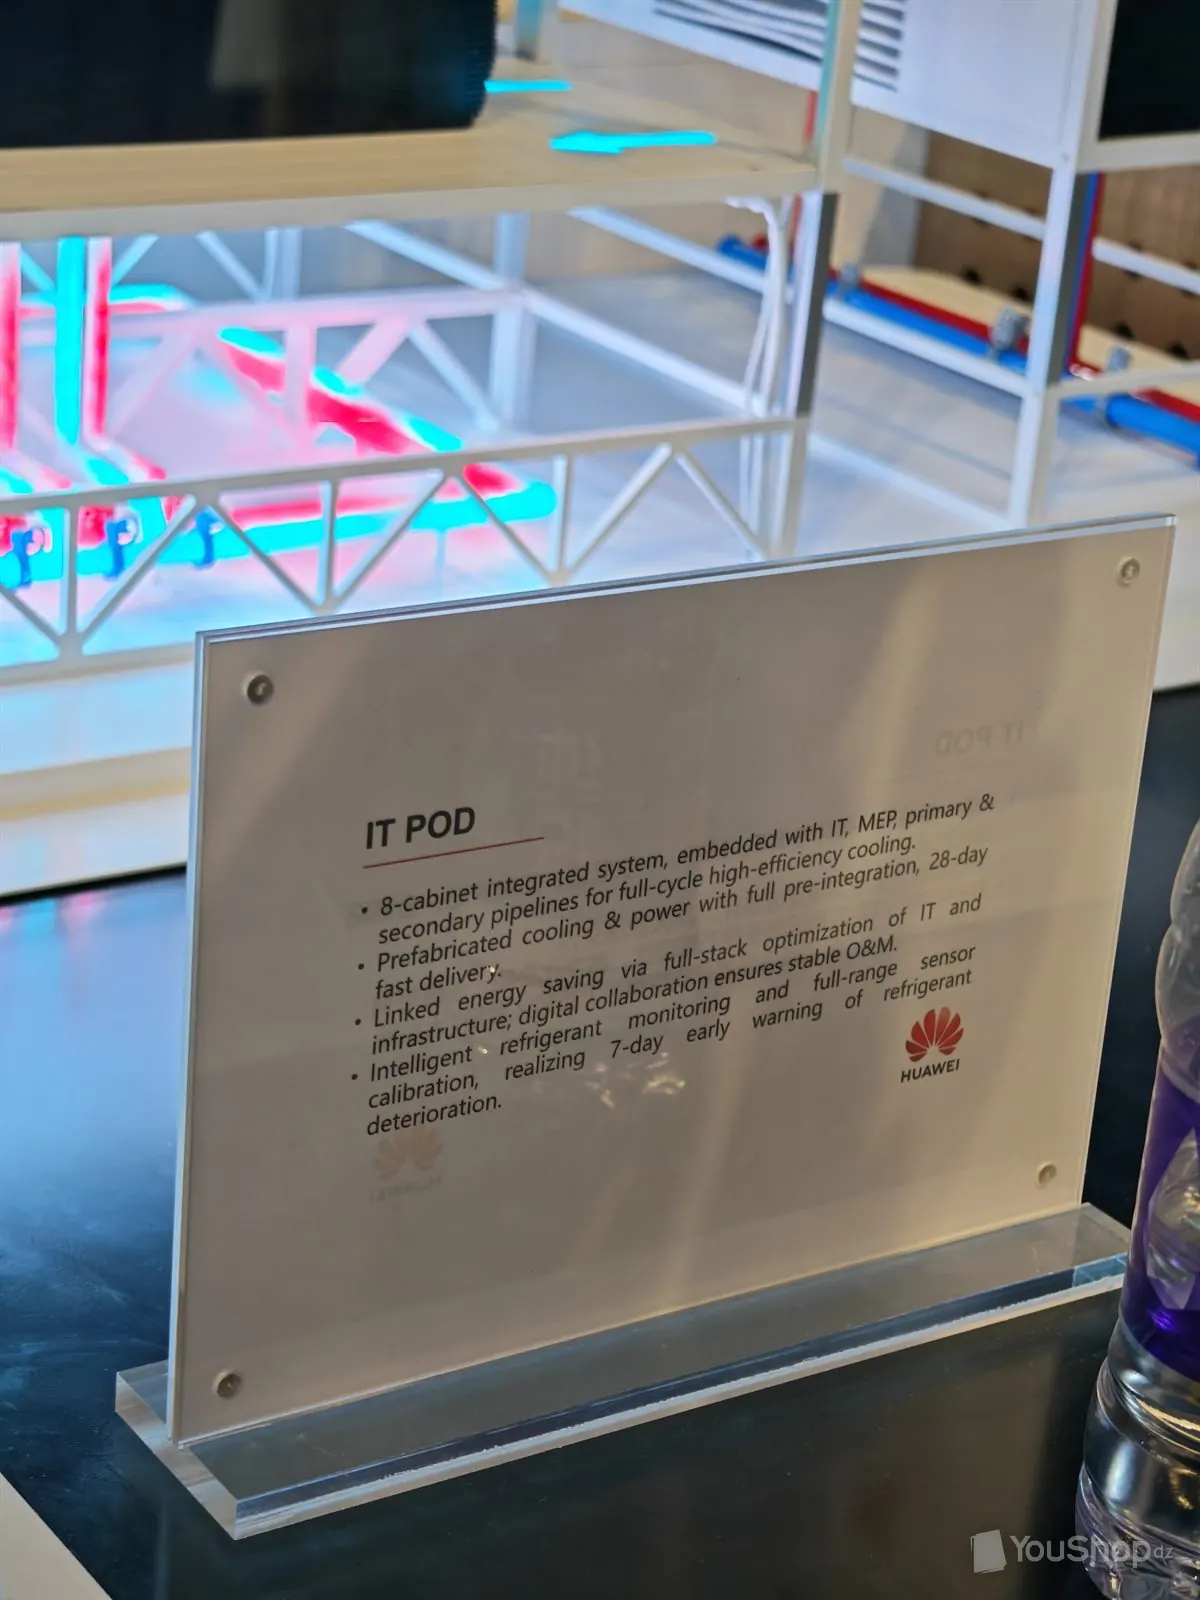
Ce que dit la fiche exposée — IT POD
- 8-cabinet integrated system, embedded with IT, MEP, primary & secondary pipelines for full-cycle high-efficiency cooling.
- Prefabricated cooling & power with full pre-integration, 28-day fast delivery.
- Linked energy saving via full-stack optimization of IT and infrastructure; digital collaboration ensures stable O&M.
- Intelligent refrigerant monitoring and full-range sensor calibration, realizing 7-day early warning of refrigerant deterioration.
Fiche photographiée sur le stand, 17/09/2026.
En clair : les huit baies arrivent avec l’informatique, le MEPMEP — Mechanical, Electrical, PlumbingLes lots techniques du bâtiment : froid et ventilation, électricité, plomberie. et les deux boucles de refroidissement pré-intégrés en usine. Huawei annonce 28 jours de livraison et une alerte précoce, sept jours à l’avance, sur la dégradation du fluide frigorigène. Côté froid, c’est le passage du dépannage à la maintenance prédictive.
Et pour une entreprise algérienne ?
Ni le FusionModule2000 ni l’IT POD ne figurent à notre catalogue en ligne : ce sont des affaires de projet, que nous montons avec le constructeur en tant que Partenaire Élite Huawei. C’est le sujet d’une banque, d’un opérateur, d’une université ou d’une administration qui construit — plus rarement celui d’une salle de trois baies. Si vous êtes dans le premier cas, un bâtiment neuf ou une extension à équiper, écrivez-nous : nous instruisons le dossier avec les équipes projet Huawei.
Ce qui s’applique tout de suite, en revanche, c’est la méthode : traiter le local technique, le câblage puis l’alimentation secourue comme un lot unique, et non comme trois commandes passées à des mois d’écart. Dernière prudence : les 28 jours sont ceux qu’annonce la fiche Huawei, qui ne précise ni d’où part le décompte ni ce qu’il recouvre ; elle ne dit rien du transport, du dédouanement ni du génie civil — souvent les postes les plus lourds d’un planning algérien.
Reste la part invisible. Sur un autre stand, Huawei chiffrait le matériel à 15 % du coût total d’un projet réseau managé, contre 45 % d’installation et 40 % de maintenance : nous y revenons dans le dossier SD-WAN et services managés. Cette répartition ne se transpose pas telle quelle à un data center, mais elle rappelle où se joue la facture — pas dans la boîte, dans la pose et l’exploitation. Un module livré pré-intégré attaque exactement cette part-là : c’est sur elle qu’il faut le juger.
Kunpeng et KunLun : des serveurs ARM
Après la salle livrée en modules, la machine seule : un îlot consacré au calcul général, dernier arrêt matériel du parcours, juste avant le retour au stand eKit. Ni IA, ni stockage — le serveur ordinaire, mais avec un autre processeur.
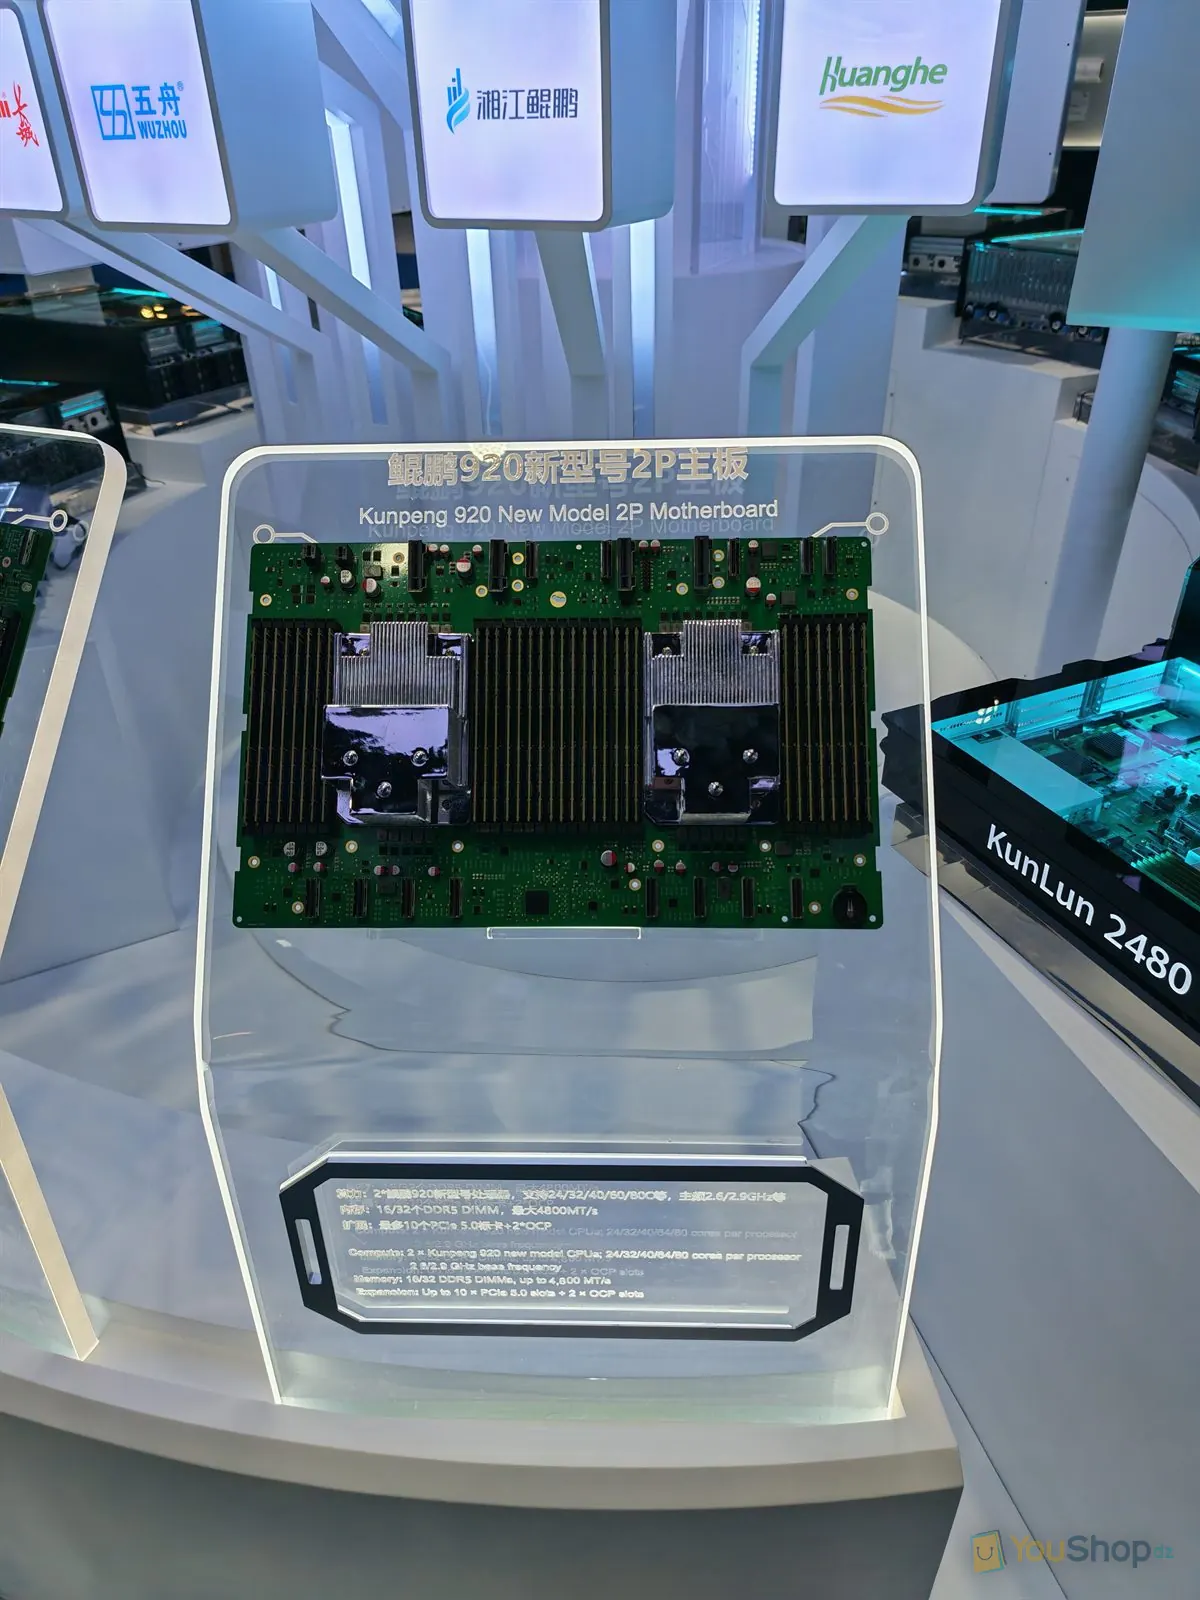
Une carte mère dressée à la verticale comme une pièce de musée, des logos de partenaires suspendus au-dessus, un panneau « 华为计算 » (Huawei Computing) sur le côté de l’îlot. Aucune mise en scène, et c’est bien le sujet : il s’agit du serveur banal, celui qui fait tourner un ERPERPProgiciel de gestion intégré : comptabilité, stocks, achats et ventes dans une même base., une base de données, quelques machines virtuelles. Ce qui change tient au processeur : Kunpeng 920, de famille ARMARMFamille d’architectures de processeurs distincte du x86 d’Intel et d’AMD. Un logiciel compilé pour l’une ne s’exécute pas tel quel sur l’autre : il doit être recompilé ou porté par son éditeur., quand les serveurs habituellement déployés en entreprise, eux, sont x86.
Ce que dit la plaque exposée — Kunpeng 920 New Model 2P Motherboard
- « Compute: 2 × Kunpeng 920 new model CPUs; 24/32/40/64/80 cores per processor; 2.6/2.9 GHz base frequency »
- « Memory: 16/32 DDR5 DIMMs, up to 4,800 MT/s »
- « Expansion: Up to 10 × PCIePCIePeripheral Component Interconnect Express : le bus d’extension standard d’un serveur, celui où se branchent cartes réseau, contrôleurs de disques et accélérateurs. 5.0 slots + 2 × OCPOCPFormat d’emplacement défini par l’Open Compute Project, surtout utilisé pour les cartes réseau de serveurs. slots »
Plaque photographiée dans la vitrine, 17/09/2026. Le texte était dédoublé par un reflet. La plaque était bilingue chinois-anglais ; nous en citons la version anglaise.
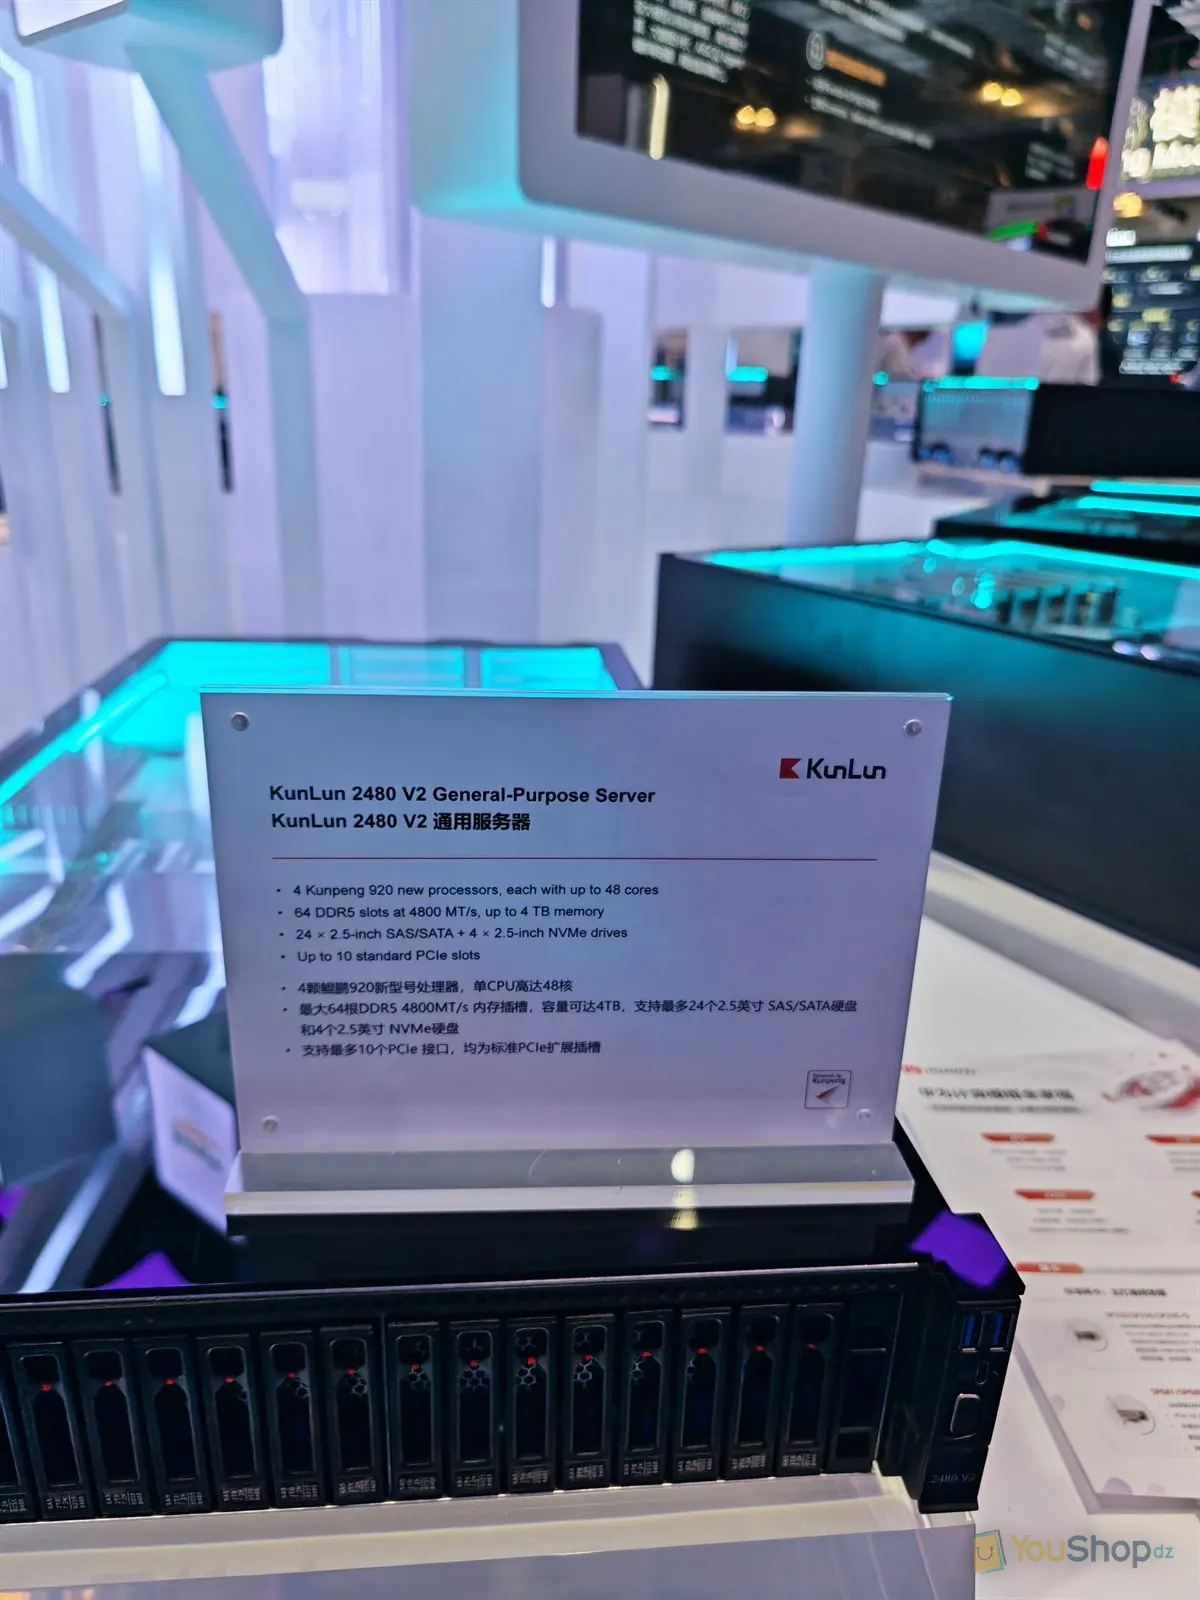
Ce que dit la fiche exposée — KunLun 2480 V2
- « 4 Kunpeng 920 new processors, each with up to 48 cores »
- « 64 DDR5 slots at 4800 MT/s, up to 4 TB memory »
- « 24 × 2.5-inch SAS/SATA + 4 × 2.5-inch NVMe drives »
- « Up to 10 standard PCIe slots »
Fiche photographiée sur le stand, 17/09/2026. Caractéristiques et formulations : affirmations du constructeur.
Trois choses à relever. Le nom imprimé en haut de la fiche n’est pas Huawei : c’est KunLun, avec son propre logo ; le badge « Powered by Kunpeng » figure en bas de page. Autrement dit, ce que Huawei signe ici, c’est le processeur ; la machine, elle, est présentée sous une autre marque. La liste officielle des partenaires de l’événement cite bien un « Kun Lun » au niveau Platinum, sans que nous puissions affirmer qu’il s’agit de la même entité. Les enseignes suspendues au-dessus de la carte mère sont, de la même façon, des partenaires de l’écosystème Kunpeng. Et la fiche du 2480 V2 décrit un serveur quadri-socket très classique : beaucoup de mémoire, beaucoup de disques, des emplacements PCIe standard. L’architecture change, pas le format. Reste une divergence, que nous laissons telle quelle : la plaque de la carte mère annonce « 24/32/40/64/80 cores » par processeur, la fiche du 2480 V2 « up to 48 cores ». Le stand n’explique pas l’écart : à confirmer auprès de Huawei.
La bonne question n’est donc pas la puissance, elle est logicielle. Un programme compilé pour x86 ne tourne pas tel quel sur ARM : son éditeur doit en publier une version. Aucune liste d’applications certifiées n’était affichée dans cet îlot, et rien sur le stand ne disait ce qu’il en est de Windows Server ou des progiciels de gestion. Cette réponse s’obtient auprès de l’éditeur de chaque logiciel, pas du constructeur du serveur.
Et pour une entreprise algérienne ?
Niveau C : ni ces cartes Kunpeng ni ces serveurs KunLun ne figurent à notre catalogue en ligne. Hors de notre catalogue ne veut pas dire hors de notre portée — un passage à l’architecture ARM se traite en projet, avec les équipes Huawei, et c’est un dossier que nous portons. Si c’est votre sujet, dites-nous quelles applications doivent tourner et sur quel parc : nous cherchons la réponse avec le constructeur (contact@youshop-dz.com). Si vous renouvelez un serveur cette année sans changer d’architecture, la décision se joue ailleurs : la liste des logiciels à faire tourner d’abord, puis le volume de mémoire, le type de disques et le mode de licence Windows — trois postes qui pèsent plus lourd qu’un nombre de cœurs. Notre guide des générations de processeurs donne les repères x86, et la lecture d’une fiche technique évite les comparaisons trompeuses.
Agentic Infra : mémoire, bac à sable, ordonnancement
Un espace de l’exposition était consacré à l’infrastructure des agents. Trois problèmes y étaient traités séparément : se souvenir, s’exécuter sans danger, partager la machine.
Avant cet îlot serveurs, le parcours passait par le logiciel. Une enseigne suspendue annonçait « Agentic AI Infrastructure / Agentic AI 基础设施 » (infrastructure d’IA agentique). Le bandeau mural blanc portait deux intitulés : « Agentic Memory Solution / Agentic记忆存储解决方案 » (solution de mémoire pour agents) et, plus à droite, « AgentSphere / Agent运行底座 » (socle d’exécution des agents). Ces briques ne se commandent pas à l’unité : elles vivent dans le cloud de Huawei et se déploient en projet. Elles disent surtout pourquoi un agent coûte cher.
La mémoire : ne pas tout relire à chaque question
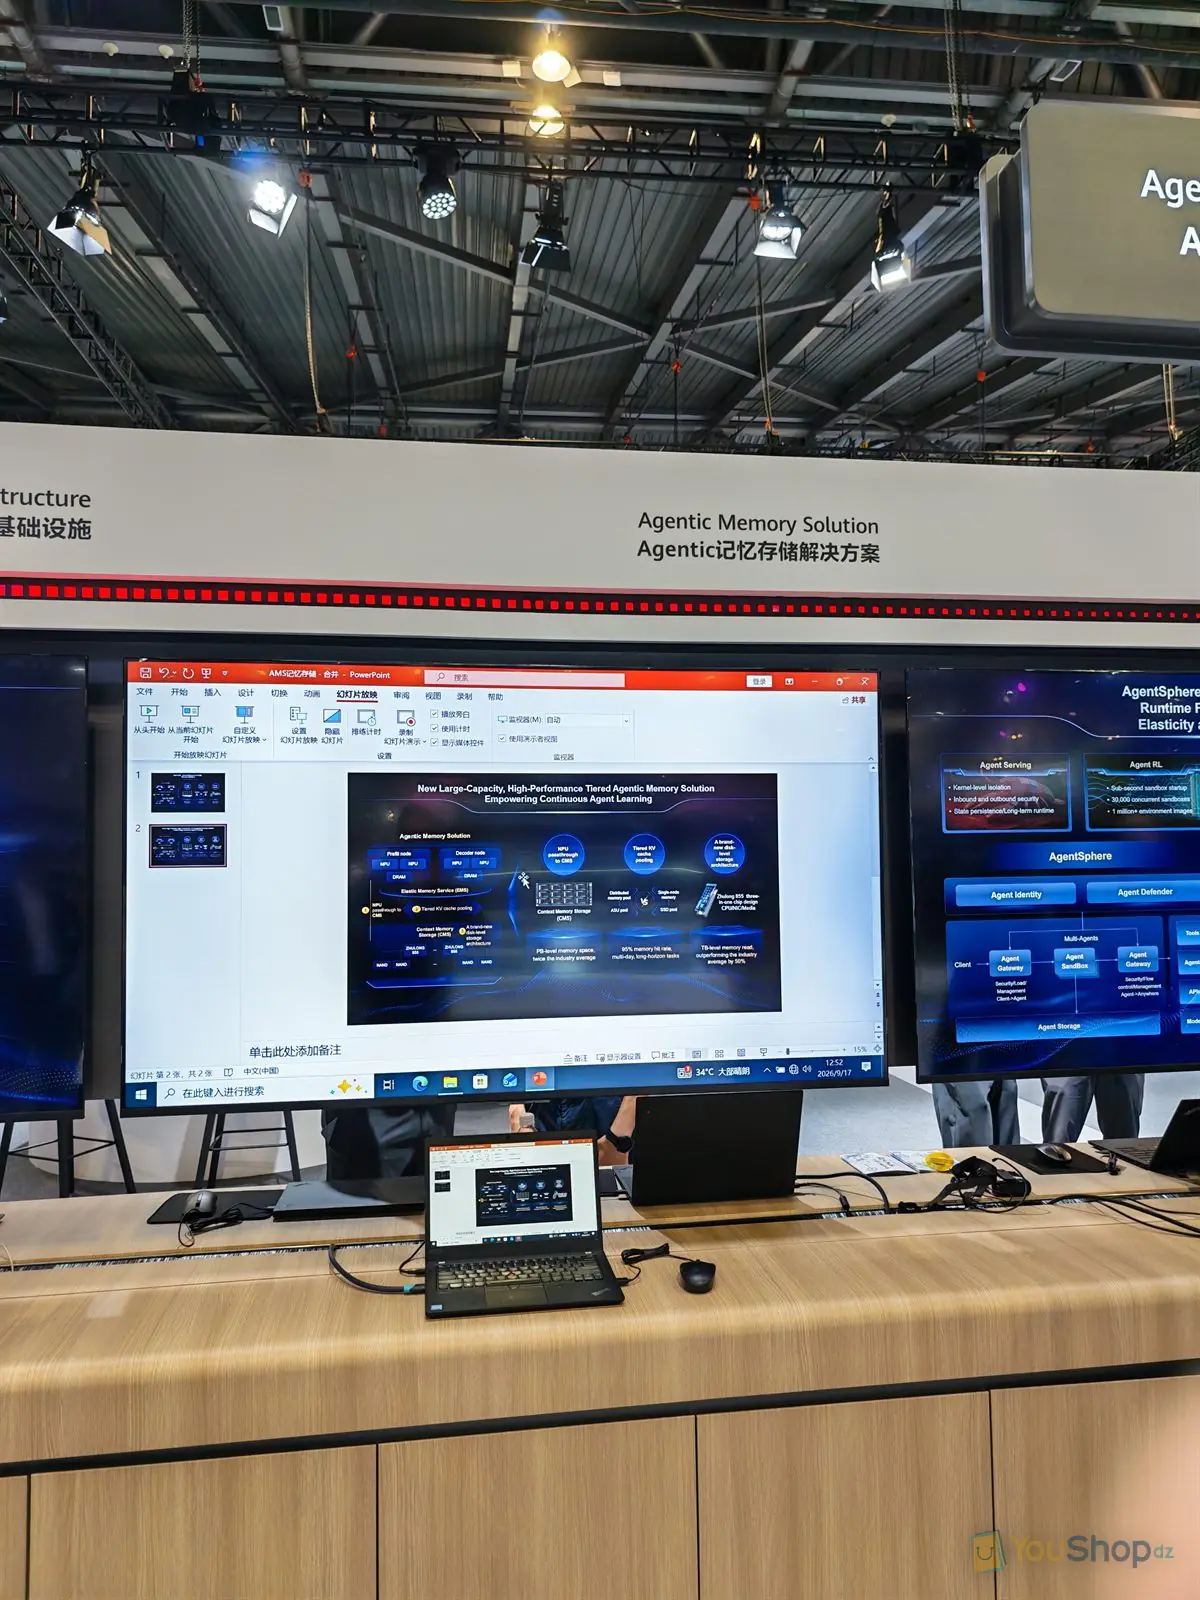
Ce que dit le slide exposé — Agentic Memory Solution
- New Large-Capacity, High-Performance Tiered Agentic Memory Solution — Empowering Continuous Agent Learning
- Elastic Memory Service (EMS) · Context Memory Storage (CMS) · Tiered KV cache pooling
- PB-level memory space, twice the industry average
- 95% memory hit rate, multi-day, long-horizon tasks
- TB-level memory read, outperforming the industry average by 50%
Diapositive photographiée sur le stand, 17/09/2026. Chiffres annoncés par Huawei.
Le schéma empile quatre étages : NPU et mémoire vive au plus près du calcul, un service de mémoire élastique, un stockage de contexte sur mémoire flash, des pools SSD. C’est la hiérarchie d’un poste de travail — mémoire vive, SSD, disque — transposée au data center et appliquée au KV cacheKV cacheMémoire de travail d’un modèle : l’état déjà calculé de la conversation, qu’il faut sinon recalculer..
L’enjeu est économique. Un agent qui suit un dossier pendant une semaine doit retrouver son contexte instantanément ; s’il le recalcule, la facture s’envole. D’où les 95 % de succès mémoire revendiqués sur des tâches multi-jours.
Lire la suiteRéduire
Le bac à sable : exécuter sans donner les clés
L’écran de droite détaillait « AgentSphere: A Secure, Autonomous Runtime Foundation with Rapid Elasticity and Proactive Security ». Les blocs du schéma sont parlants : Agent Gateway, Agent SandBox, Agent Storage, Agent Identity, Agent Defender, avec les mentions « Kernel-level isolation », « Inbound and outbound security » et « Session-level identity security ». Un agent ne s’exécute donc pas directement sur le serveur : il tourne dans une cellule jetable, avec une identité propre à la session. Les questions restent celles du poste utilisateur — qui surveille l’exécution, qui détient l’identité — multipliées par le nombre d’agents.
< 100 ms
de démarrage d’un bac à sable, et 100 000 créés par minute en lot — chiffres du slide AgentSphere
30 000
bacs à sable simultanés, et plus d’un million d’images d’environnement prêtes à l’emploi, annoncés sur le même slide
128K → 100M
la progression affichée pour l’infrastructure de mémoire à long terme, sur le grand écran LED
L’ordonnancement : une seule file pour deux calculs
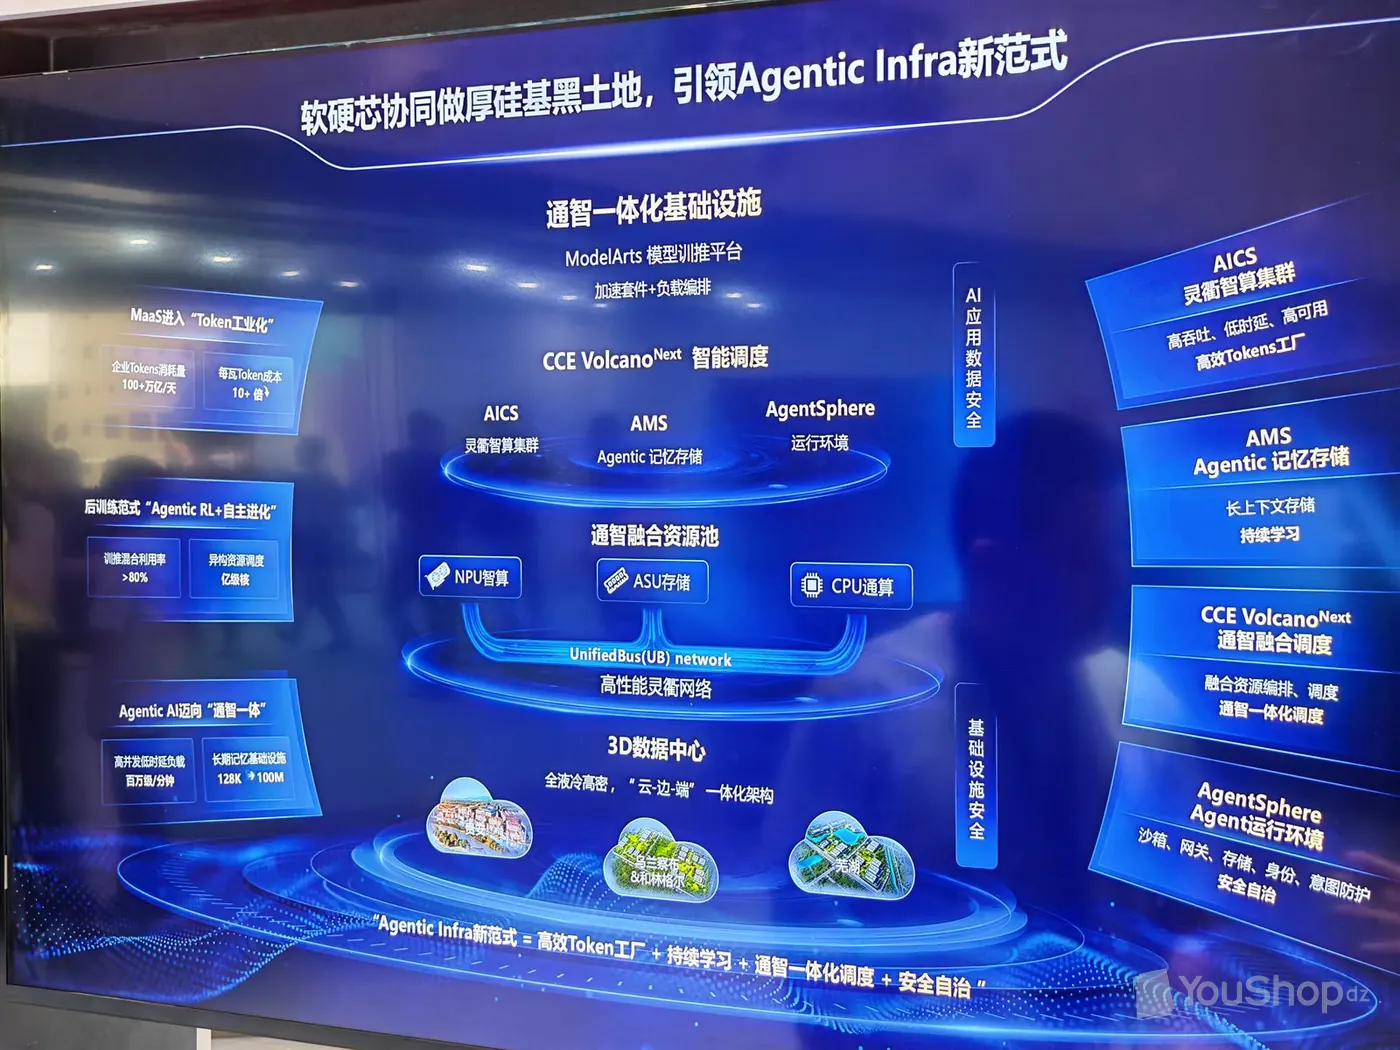
Juste à côté, un grand écran LED résumait l’ensemble sous le titre « 软硬芯协同做厚硅基黑土地,引领Agentic Infra新范式 » (synergie logiciel-matériel-puce, mener le nouveau paradigme Agentic Infra). La pile se lit de bas en haut : un socle « 3D数据中心 » (centre de données 3D) illustré par trois sites, puis un pool mêlant NPU智算 (calcul IA), ASU存储 (stockage) et CPU通算 (calcul général), relié par le « UnifiedBus (UB) network » ; au-dessus AICS 灵衢智算集群 (cluster de calcul intelligent), AMS Agentic 记忆存储 (stockage de mémoire pour agents) et AgentSphere 运行环境 (environnement d’exécution) ; puis CCE Volcano Next, étiqueté 智能调度 (ordonnancement intelligent), et enfin ModelArts (entraînement et inférence).
La thèse de Huawei tient dans une formule de l’écran, 通智一体化调度 (ordonnancement intégré calcul général / calcul intelligent) : une seule file pour les deux. Deux chiffres l’accompagnent : un taux d’utilisation mixte entraînement-inférence annoncé à plus de 80 % et un coût du tokenTokenUnité de découpage du texte traitée par un modèle, devenue l’unité de facturation des services d’IA. par watt divisé par plus de dix. La demande, elle, est chiffrée dans un encadré du même écran : « 企业Tokens消耗量 100+万亿/天 » (consommation de tokens des entreprises, plus de 100 000 milliards par jour), sous la mention « Token工业化 » (industrialisation du token).
Et pour une entreprise algérienne ?
Ces briques ne figurent pas à notre catalogue en ligne : elles se montent en projet avec Huawei Cloud, et nous en sommes l’interlocuteur côté algérien. Ce qui sert dès aujourd’hui, ce sont les questions à poser dès qu’un éditeur vous vend un « agent IA ». Où est stockée sa mémoire ? Dans quel isolement son code s’exécute-t-il ? Quelle identité utilise-t-il pour entrer dans votre ERP, et qui peut la révoquer ? Comment la consommation est-elle facturée ? Sans ces réponses, deux devis ne sont pas comparables.
Cloud Stack et l’« usine à tokens »
Un panneau et un écran, croisés à deux endroits de l’exposition, racontent la même bascule : le cloud redescend chez le client, et le calcul se compte en jetons facturés.
Toujours dans le même espace Huawei Cloud : signalétique « Hybrid Cloud / 混合云 » (cloud hybride), enseigne « Huawei Cloud / 华为云 ». Un panneau blanc rétroéclairé annonce « Huawei Cloud Stack, Designed for Enterprise Intelligence » / 华为云Stack,智能时代更懂政企的云 (le cloud qui comprend le mieux administrations et entreprises à l’ère de l’intelligence). De part et d’autre de l’anneau central « Go Intelligent / 政企数智化 » (numérisation et intelligence des administrations et entreprises), deux mots : AI, « Key Production Factor », et Data, « Core Production Engine ».
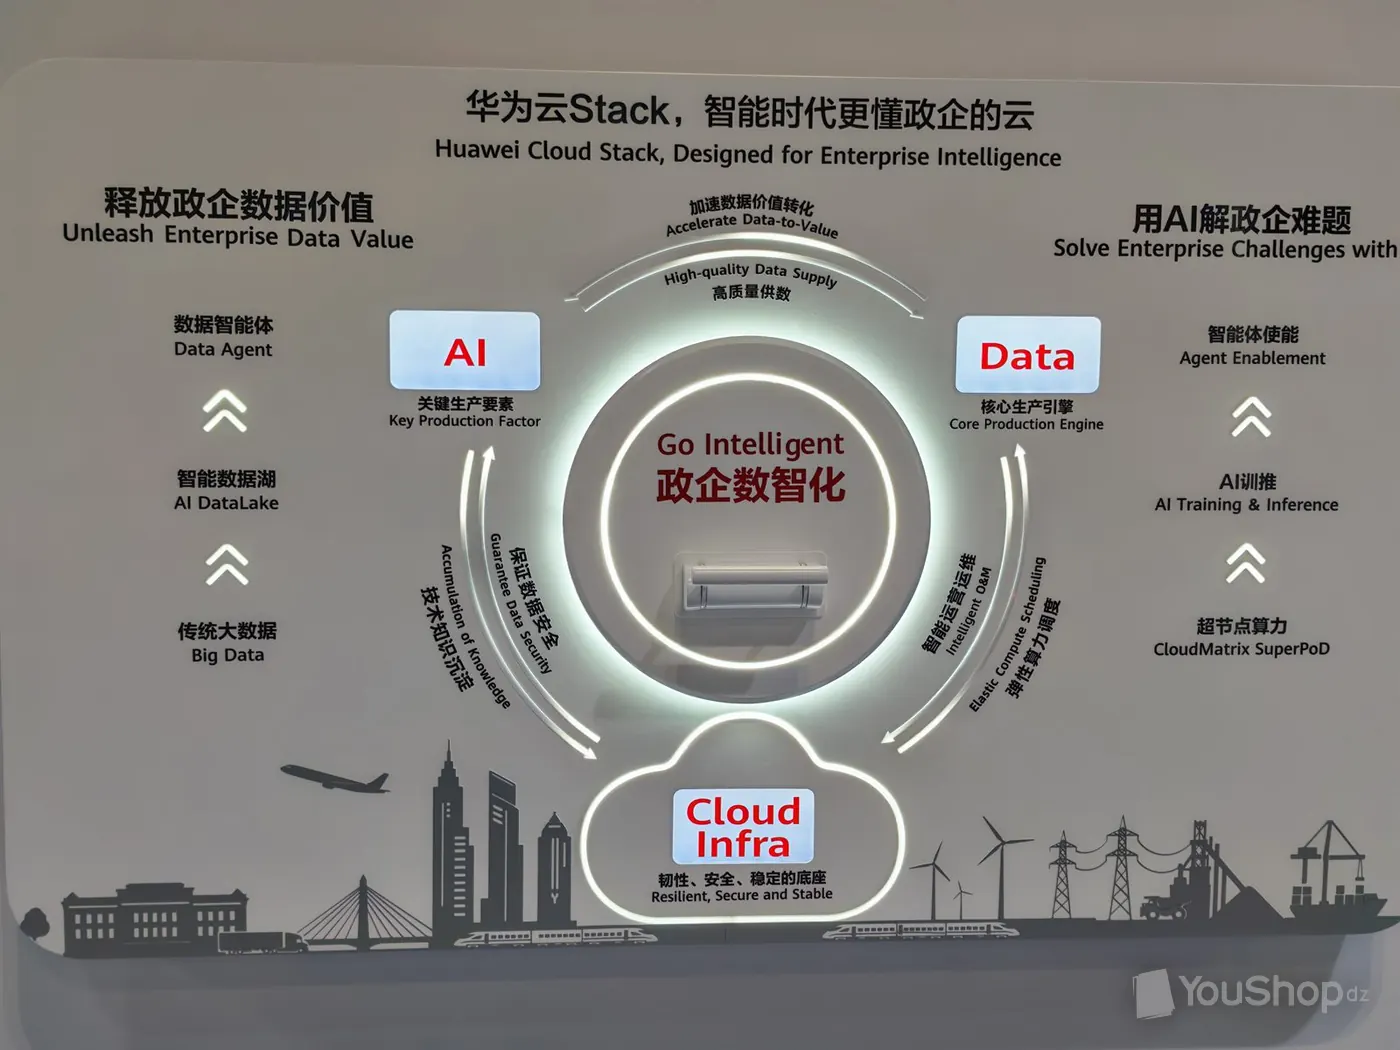
À gauche, sous « Unleash Enterprise Data Value », une progression en trois paliers : du « Big Data » au lac de données intelligent, puis au « Data Agent ». À droite, même pente, du « CloudMatrix SuperPoD » à l’« AI Training & Inference », puis à l’« Agent Enablement ». Autour de l’anneau courent six mentions en arcs, dont « Guarantee Data Security », « Intelligent O&M » (exploitation et maintenance) et « Elastic Compute Scheduling ». Traduit : Huawei propose d’installer chez le client, administration ou entreprise, sa pile de cloud hybride, agents de données compris. Un projet à mener avec le constructeur : Cloud Stack ne figure pas à notre catalogue en ligne, mais nous sommes Partenaire Élite Huawei et nous portons ce type de dossier avec ses équipes projet.
L’usine à tokens, couche par couche
Plus tôt dans le parcours, un grand écran tenait le même raisonnement côté calcul, sous l’enseigne murale « Managed AIDC and Operations Services / AIDC托管与运营 » (hébergement et exploitation d’AIDCAIDCCentre de données conçu pour l’intelligence artificielle. L’enseigne affiche le sigle tel quel, sans le développer.). Au centre, une architecture « Tokens 工厂架构 » — usine à jetons — empilée en quatre couches numérotées et proposée en service managé : ce que Huawei vend ici n’est pas une machine, c’est une exploitation.
Ce que dit l’écran exposé — « Tokens 工厂架构 »
- Bandeau : 开源开放的分层架构驱动敏捷创新,高效规模化Tokens普惠千行百业 (architecture en couches, ouverte, pour une innovation agile et des tokens à grande échelle dans tous les secteurs)
- Couche 1 — 硬件基础设施 (infrastructure matérielle) : AI集群 (grappe IA), 通算 (calcul général), 智算 (calcul intelligent), 数据中心网络 (réseau de centre de données), 存储 (stockage)
- Couche 2 — 软件基础设施 (infrastructure logicielle), extrait : 算力服务底座 (socle de services de calcul), 操作系统 (système d’exploitation), 异构计算架构 (architecture de calcul hétérogène), AI计算框架 (cadre de calcul IA)
- Couche 3, exploitation — 运营平台, extrait : 模型集市 (marché de modèles), 资源管理 (gestion des ressources), 计量计费 (comptage et facturation)
- Couche 3, passerelle — 模型网关, extrait : 智能路由 (routage intelligent), 成本分析 (analyse des coûts), 指标监控 (supervision des indicateurs), 安全护栏 (garde-fous)
- Couche 3, modèles — SOTA模型 (modèles de pointe, « state of the art ») : « LLM » (grands modèles de langage) DeepSeek V4-Pro, DeepSeek V4-Flash, GLM-5, GLM-5.1 · 编程 (programmation) GLM-5.1, MiniMax-M2.7 · 多模态 (multimodal) Kimi-K2.6, Qwen3.6 · 公网提供的模型服务 (services de modèles fournis depuis l’internet public)
- Couche 4 — 场景应用 (applications) : AI Coding, Agent, Web, App, Copilot
Écran photographié sur le stand, 17/09/2026. Architecture et liste de modèles telles qu’affichées par Huawei.
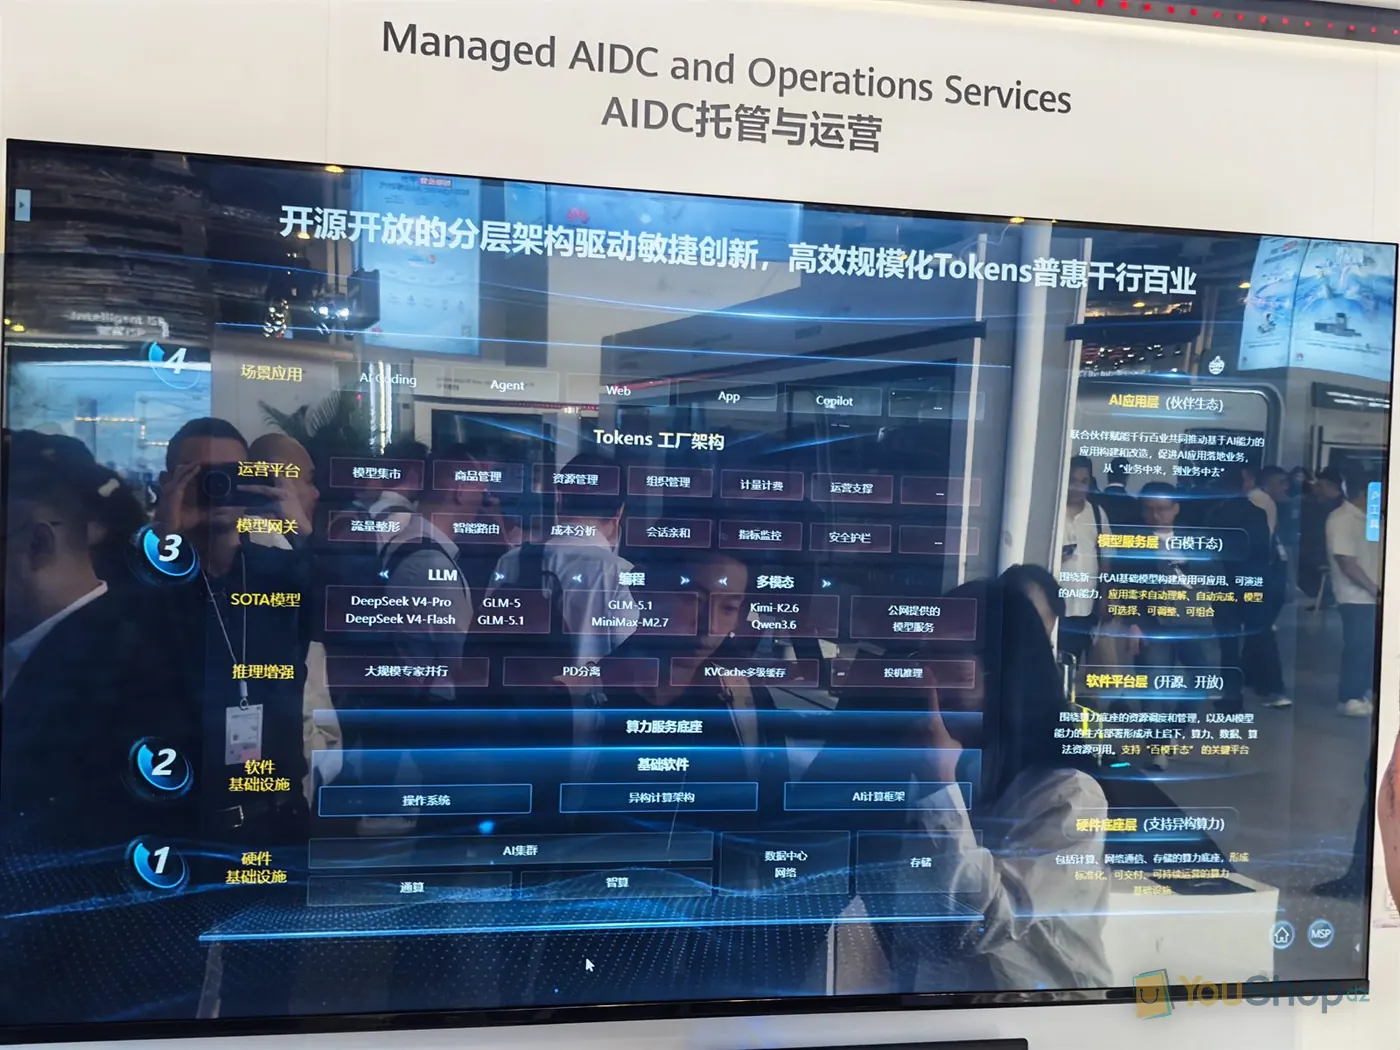
Deux choses à retenir. Aucun des modèles listés n’est un modèle Huawei : le constructeur vend l’usine, pas le modèle. Et l’étage le plus instructif est celui du milieu — plateforme d’exploitation et passerelle de modèles : routage intelligent, analyse des coûts, comptage et facturation, garde-fous. C’est là que se règle la question qui intéresse un directeur financier : combien coûte un assistant, et qui peut l’appeler.
Et pour une entreprise algérienne ?
Cloud Stack et l’AIDC managé ne se commandent pas en ligne : ce sont des projets d’opérateur, de grand compte ou d’administration, montés avec Huawei — le terrain de notre dossier sur les grands réseaux. Aux questions posées plus haut sur les agents s’en ajoutent deux, avant d’ouvrir un assistant IA à vos équipes : quel modèle exactement, et quelles données quittent l’entreprise pour l’atteindre. Sur la souveraineté, nous en restons à une question ouverte : le cadre applicable à l’hébergement de données en Algérie est à vérifier auprès des autorités compétentes. Les briques que nous fournissons se situent en amont : licences bureautiques, authentification des comptes et protection des postes. Et pour la partie haute — cloud hybride installé chez vous, AIDC managé —, décrivez-nous ce que vous cherchez à héberger : nous ouvrons le dossier avec les équipes Huawei, au 0558 13 01 81.
Et votre salle serveurs ?
Rien de tout cela ne se pose tel quel dans un local algérien. Ce qui voyage, en revanche, c’est l’ordre des priorités : l’air, l’énergie, les serveurs ensuite.
Le confinement avant la puissance de climatisation
Sur la maquette, les baies « IT Rack » et « Smart Cooling » alternent et l’allée est fermée : le froid n’est pas soufflé dans une pièce, il est confiné entre la source et les serveurs. Dans un local de PME, la même idée s’applique sans rien acheter d’exotique : baies orientées dans le même sens, emplacements vides obturés, air chaud empêché de revenir devant les aspirations. Mélanger les deux flux, c’est climatiser en pure perte.
L’onduleur n’est pas un accessoire de fin de chantier
En bout de module, la maquette porte une baie « Integrated UPS », soit un onduleur intégré à la rangée : l’énergie fait partie du produit. Chez nous, elle arrive souvent en dernier, sur ce qui reste du budget. L’ordre utile est inverse : relever la puissance réellement appelée par les équipements à protéger, puis dimensionner l’onduleur sur ce total et sur l’autonomie visée. En amont, la protection électrique — terre, parafoudre, régulation — pèse plus lourd sur la durée de vie du matériel que la marque des serveurs.
Redonder ce qui compte, pas tout
Le module industriel pousse l’idée à son terme : la fiche du FusionModule2000 revendique « UPTIME Tier IV Ready » et une « Innovative power supply architecture to support continuous cooling », soit une salle conçue pour qu’aucune panne isolée ne l’arrête. Affirmation Huawei, et ambition de centre de données. Dans un local d’entreprise, la redondance utile est plus courte : double alimentation sur les serveurs qui portent la production, batteries dont on connaît l’âge, un second point de froid ou, à défaut, une procédure d’arrêt écrite et testée. On redonde ce que l’on ne saurait pas réparer dans la journée ; le reste s’assume.
Le PUE : un chiffre de constructeur, pas une promesse
On l’a vu : 1,111 sur la fiche, et sur le slide voisin une progression affichée de 1,5 à 1,111. Affirmations Huawei, obtenues dans ses conditions de mesure et sous un autre climat : elles ne se recopient pas dans un cahier des charges. L’indicateur reste pourtant le plus honnête qu’une direction puisse réclamer : relevez le vôtre avant d’engager des travaux.
Et pour une entreprise algérienne ?
Le module préfabriqué commence là où une salle de gestion s’arrête : quelques serveurs, un stockage, du réseau restent très en deçà des densités affichées sur le stand. Le sujet, chez vous, n’est donc pas la densité : c’est la stabilité. Trois points décident — une arrivée électrique dédiée et mise à la terre ; une climatisation qui tient les heures chaudes ; un local fermé, propre, sans canalisation d’eau au-dessus des baies. Un quatrième s’oublie toujours : qui détient la clé.
Quand un module préfabriqué a vraiment du sens
Trois situations, pas davantage : un site neuf sans local exploitable, une charge dense que le bâtiment ne sait pas refroidir, ou un délai contraint — la fiche IT POD annonce « 28-day fast delivery » pour huit baies préintégrées. Sinon, reprendre l’existant reste plus rapide et moins coûteux. Ces modules ne figurent pas à notre catalogue en ligne, ce qui ne les met pas hors de notre portée : ce type d’opération se monte en projet avec Huawei, et nous le portons. Pour une salle déjà en place, notre terrain commence en amont, sur le local technique.
Un onduleur par baie, ou un onduleur pour la salle ?
En règle générale, au-delà de deux ou trois baies, l’onduleur de salle l’emporte : une maintenance, un jeu de batteries, un report d’alarme. L’autonomie utile est celle qui permet d’éteindre proprement.
Notre local chauffe en été : par quoi commencer ?
Par la circulation de l’air, avant tout achat : baies dans le même sens, emplacements vides obturés, câbles qui n’obstruent pas les grilles. Si la chaleur persiste, la plage admise se lit sur les fiches de vos serveurs.
Le PUE a-t-il un sens pour une salle de trois baies ?
Comme indicateur de suivi, oui ; comme comparaison avec un data center, non. Ce qui compte : la part de la facture qui ne fait pas tourner les serveurs, mesurée avant puis après travaux.
Un IT POD est-il envisageable en Algérie ?
C’est un projet, pas une commande : au délai de fabrication s’ajoutent le génie civil, l’arrivée électrique, le transport et la mise en service. Cette gamme ne figure pas à notre catalogue en ligne ; elle se traite au cas par cas avec les équipes Huawei, et nous portons le dossier. Pour une salle existante, nous intervenons directement.
Reprendre votre salle serveurs
Envoyez-nous le plan du local, la liste des équipements et la puissance disponible. Nous répondons par un état des lieux et un devis.